Error Coding Basics

Niko:「最近 Ubuntu 官網下載超慢,我改從淡江大學的 mirror 下載 Ubuntu iso 檔。」
Nini:「你下載後有驗證 SHA 嗎?」
Niko:「蛤?」
Nini:「萬一淡江的 mirror server 被駭客入侵呢?駭客把原本的 iso 換成植入後門的版本,你下載 iso 裝進電腦,後門就跑進你家了。」
Nini 指著 mirror 頁面上一個叫做 SHA256SUMS 的檔案:「看到這個沒有?這是 Ubuntu 官方對 iso 檔算出來的指紋。你下載後自己再算一次 SHA256,跟這個指紋對照。對得起來,就代表檔案沒被動過;對不起來,可能是淡江被入侵,或是傳輸過程出錯了,總之都不能用。」
Niko 點點頭:「喔喔 ... 所以 SHA 是用來抓錯的?」
「對,」Nini 說,「這叫做 error detection。他能告訴你資料壞了,但不能告訴你壞在哪裡。」
Niko:「那如果是我自己硬碟裡的檔案呢?硬碟壞了我也沒地方重抓啊。」
Nini:「這時候光抓錯就不夠了,你會希望系統能更正回來。這就是另一種 code 的工作。生活中常見的 QR Code,被弄髒、刮傷、甚至缺了一角,掃描器還是讀得出來,因為 QR Code 內建一種叫 Reed-Solomon 的 code,能自動把缺掉的部分還原回來。連身份證字號也有驗證碼,但只能抓錯不能更正。」
為了更正錯誤,必須在寫入資料時就加入一些冗餘 (redundancy),讓系統能從這些冗餘重建出原始資料。
Erasure 與 Error
在儲存系統中,資料壞掉可以分成兩類:
Erasure:你知道哪一塊資料不見了。例如,一台 NAS 中某顆硬碟整顆壞掉,你不需要去判斷「資料是不是壞的」,你直接知道「第 3 顆硬碟讀不到」。
Error:資料偷偷被改寫了,但你不知道。例如 NAND cell 因為老化導致 bit flip,或 DRAM 被宇宙射線打到,錯了一個 bit。這種叫做 silent corruption,比 erasure 更難處理,因為你連「是不是壞了」都不知道。
Error coding 的回應方式也分成兩種:
Detection (抓錯):判斷資料是否有錯,有錯就丟掉、重試、或交給上層處理。CRC、SHA、各種 checksum 都屬於這類。
Correction (更正):自動把錯誤修回正確的資料。Hamming code、Reed-Solomon、LDPC 都屬於這類。
(n, k) Code 框架
無論哪種 code,背後都共用同一個框架:
- 你有 個 data symbol (大小可以是 bit、byte、或更大的 block)
- Encoder 把它變成 個 symbol,其中
- 多出來的 個 symbol 就是 redundancy,或稱 parity
- 我們稱這個 code 是 code
合法的 個 symbol 組合稱為 codeword。不是隨便一串 個 symbol 都是 codeword。如果你拿一個合法 codeword 去翻幾個 bit,結果很可能不再是合法的 codeword,這樣 receiver 就能知道這個訊息出錯了。
我們也用 code rate 來描述一個 code 的效率。 越接近 1,redundancy 越少、儲存效率越高,但更正能力越弱; 越小則反過來。所有 error coding 的設計都在這個 trade-off 上做選擇。
舉一個例子:你要儲存 7 bit 的 ASCII 字元,加一個 parity bit 變成 8 bit,這就是 code,code rate ,redundancy 12.5%。
Hamming Distance 與更正能力
兩個 codeword 之間的 Hamming distance,就是它們有幾個 bit 不一樣。例如 1011010 和 1001010 只有第三個 bit 不同,distance 為 1。
一個 code 的 minimum distance ,就是這個 code 中所有 codeword pair 中,距離最近的那一對的 distance。 是這個 code 最重要的系統性質,它決定這個 code 能做到什麼:
| Minimum Distance | 能抓到 | 能更正 | 能修復 erasure |
|---|---|---|---|
| 1 個 error | 0 | 1 個 erasure | |
| 2 個 error | 1 個 error | 2 個 erasure | |
| 4 個 error | 2 個 error | 4 個 erasure | |
| 一般情況 | 個 error | 個 error | 個 erasure |
(不用背公式! 但這張表的精神要記得: 越大,這個 code 越強。)
幾何直覺:把每個 codeword 想像成 維 bit 空間中的一個點。如果所有合法 codeword 都至少相距 ,那麼一個 bit error 會把 codeword 移動 1 步,只要 就能抓到 (因為移動後不再是 codeword)。要更正錯誤,receiver 會選離收到的 sequence 最近的 codeword;只要 errors 移動的距離小於 ,就保證最近的還是原本那個 codeword。
我們不會深入推導這個結論,但只要記住「 越大越強」,就足以讀懂後面所有 storage 論文裡關於 ECC 的描述。
三個經典的 Code
接下來看三個經典 code,每一個都是上面這個 框架的具體實例。
Two-Repetition Code: code,
最直覺的 code 是把每個 bit 送兩次:message 長 1 bit,codeword 長 2 bit,code rate ,合法 codeword 只有 00(代表 0)和 11(代表 1)。

00 與 11 之間的 Hamming distance 是 2,所以 ,對照前面那張表:能 detect 1 個 error,correct 0 個。Receiver 收到 01 知道一定有錯(不是合法 codeword),但沒辦法決定 sender 原本送的是 0 還是 1,因為 00 和 11 離 01 一樣近。
Parity Bit: code,
最簡單的 code,只多加一個 bit。這個 bit 等於前面所有 bit 的 XOR:前面有奇數個 1,parity bit 就是 1;偶數個 1 就是 0。Receiver 收到後,把全部 個 bit 一起 XOR;結果是 0 表示沒翻,不是 0 表示至少有一個 bit 翻了。
Parity 只能抓到「奇數個」錯誤,無法更正。 是 detect 1 / correct 0 的 code。
不要覺得這個太弱:RAID-5 的 parity 就是這個東西,只是把 bit 換成整顆 disk。RAID-5 中如果一顆 disk 壞了 (這是 erasure,不是 error),可以從剩下的 disk XOR 算出來救回來。 的 code 剛好能修復一個 erasure,所以 RAID-5 能容許一顆 disk 壞掉。
Hamming(7,4) Code: code,
1950 年由 Hamming 設計,是第一個真正能更正錯誤的 code。它把 4 個 data bit 加 3 個 parity bit 編成 7 個 bit,每個 parity 覆蓋一組特定的 data bit。Receiver 收到 7 個 bit 後,可以從 parity check 的結果直接「指認」出哪一個 bit 翻了,然後 flip 回去。
表示能 detect 2 個錯誤、correct 1 個錯誤。Code rate 。
DRAM ECC 用的就是 Hamming code 的變種,叫做 SEC-DED (Single Error Correction, Double Error Detection),能更正 1 bit 錯誤、抓到 2 bit 錯誤。每個 64-bit word 加 8 個 ECC bit 就能達到這個能力。所以 ECC RAM 比一般 RAM 貴,是因為它真的多了一塊 chip 在存 ECC bit。伺服器幾乎都有裝 ECC RAM,桌機則多半沒有。
CRC (Cyclic Redundancy Check)
CRC 是最常見的 detection-only code。CRC 的特性如下:
- Detection only:不能更正,只能抓錯。
- Burst error 友善:如果 個連續 bit 同時翻 (例如磁頭刮過一條磁軌、或一塊 NAND 區域同時老化),標準 CRC-32 能抓到所有長度 的 burst error。一般用 random error model 設計的 code 不會有這個性質。
- 計算成本極低
CRC 用在幾乎所有需要快速抓錯且高 throughput 的場景:
- HDD 和 SSD 每個 sector 後面都接一個 CRC
- TCP 封包、Ethernet frame、USB 封包都用 CRC
- 檔案系統的 block checksum
MDS Code 與 Reed-Solomon
那給定 , 最大多少呢?也就是說,「相同的 redundancy,更正能力的理論上限是多少?」
答案叫做 Singleton bound:
能達到這個上限的 code,叫做 MDS code (Maximum Distance Separable)。MDS code 在「相同 redundancy 下擁有最強更正能力」。
換成人話:一個 MDS code,可以容許任意 個 erasure。不是「某幾個」,是「任意」。隨便挑 個 shard 移除,剩下的 個一定能還原出原始資料。這個性質非常強,也是分散式儲存系統普遍使用 MDS code 的原因。
最常用的 MDS code 是 Reed-Solomon (RS) code,1960 年提出。RS 的細節 (它怎麼建構、怎麼解碼) 涉及 Galois field 上的多項式運算,我們不講,有興趣同學請觀看此強大教學。它的性質很單純:
- : 個 data symbol, 個 parity symbol
- 任意 個倖存的 symbol 都能還原出原始資料
- 任意 個 erasure 都能修復
下一個單元我們會學習到磁碟陣列,而 RAID-5 / RAID-6 的數學本質可以如此對照:
- RAID-5 = ,容許 1 顆 disk 壞掉
- RAID-6 = ,容許 2 顆 disk 壞掉
QR Code 也是 RS code 的應用。QR Code 規格中提供 L/M/Q/H 四種 error correction level,分別容許大約 7% / 15% / 25% / 30% 的 codeword 損毀。L level 是 RS code 的低 redundancy 設定,H level 則加入大量 parity symbol,所以 QR Code 即使少了一角仍然能掃出來。

Backblaze 的 17+3 RS Code
Backblaze 是一家專做雲端備份的公司,他們的 storage 後端用 RS(20, 17) code:
- 每筆檔案被切成 17 個 data shard
- 算出 3 個 parity shard
- 共 20 個 shard,分散到 20 台不同的 storage pod 上
你可以隨便挑 3 台 pod 拔掉 (或讓它們同時壞掉),剩下的 17 台仍然能還原任何一筆檔案。
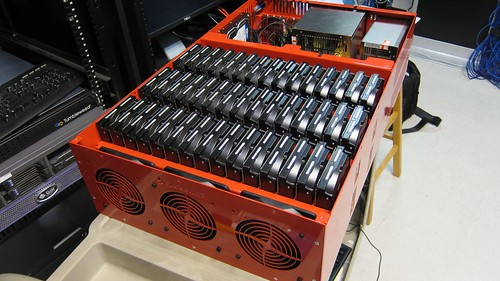
- Storage overhead 只有 3/17 ≈ 17.6%。如果用三副本 (replication) 達到「容許 2 台壞掉」的能力,要多花 200% 空間。RS(20, 17) 達到「容許 3 台壞掉」的能力,只多花 17.6%。在 PB 等級的 cluster,這個差距會直接決定每年要買幾櫃硬碟。
- Parameter 怎麼挑: 越大 (越接近 ),space efficiency 越高,但 (1) decode 計算成本越高,(2) 一個 read 要從 17 台 pod 拉資料,網路成本也越高。Backblaze 選 17+3 是這幾個 trade-off 的平衡。
- Reconstruction:一台 pod 壞掉時,系統要從剩下的 19 台讀資料,重算出該 pod 上所有 shard 的內容,寫到一台新 pod。這個 reconstruction 過程是 erasure coding 系統的主要 bottleneck,後面進階課程會討論這個問題以及對應的 Local Reconstruction Codes (LRC)。
Error Coding 在 Storage Stack 中的位置
最後從宏觀視角看一下每一層 storage 用什麼 code、解什麼問題。
| Stack 層 | Code 類型 | 解決什麼 | 抓錯 / 更正 |
|---|---|---|---|
| NAND flash on-die | LDPC code | bit flip from cell wear | 更正 |
| DRAM | SEC-DED Hamming | 宇宙射線 bit flip | 更正 |
| HDD sector | CRC | 磁頭/磁面 bit error | 抓錯 |
| SATA / NVMe 傳輸 | CRC | 傳輸過程 bit error | 抓錯 |
| File system (ZFS, Btrfs) | SHA / fletcher | silent corruption | 抓錯 |
| RAID | XOR parity 或 RS | 整顆 disk 壞掉 | 更正 (對 erasure) |
| 分散式儲存 | RS / LRC | 整個 node / rack 壞掉 | 更正 (對 erasure) |
這個分工讓每一層只解決自己最適合的問題:NAND 上的 bit flip 用 LDPC 就近修掉,不要讓它傳到 host;整顆 disk 壞了用 RAID 或分散式 EC 來救,因為這層才看得到「disk 是一個整體」。
為什麼 SSD 不用 Hamming Code?
LDPC (Low-Density Parity-Check) code 是 SSD on-die ECC 用的 code。為什麼不用 Hamming Code? 主要原因是 NAND 的 raw bit error rate 隨著 P/E cycle 不斷升高。一顆全新 SSD 可能每 bit 才有一個 error,但用了幾千個 P/E cycle 後可能變成每 個 bit 就一個 error,密集到 Hamming code 完全無法處理。LDPC 能處理高 raw bit error rate,搭配 NAND 的 multi-level voltage sensing (soft decoding) 還能進一步提升更正能力。
參考資料
- Princeton COS 463 Lecture 8 - Detecting and Correcting Bit Errors,想看更詳細的數學推導可以參考。
- Brian Beach, "Reed-Solomon Codes," Backblaze Blog (2015): 17+3 RS 設計的來源說明。
自問自答
試著用自己的話回答以下問題。如果卡住了,回去重讀對應的段落。
-
Erasure 和 error 的差別是什麼?為什麼 storage 系統大部分的問題屬於 erasure?舉兩個你能想到的 erasure 例子和兩個 error 例子。
-
一個 code 的 code rate 是 。為什麼 越接近 1 表示更正能力越弱?